详细介绍
一句话结论:pdfcpu 是 Go 写的 PDF 库加命令行工具,Apache-2.0、GitHub 8.9k star、当前 0.16.4,编译出来就是一个静态二进制,不依赖 Python、Java 或外部服务。校验、优化、合并拆分、加印章水印、加解密、管附件都能做,PDF 2.0 支持是基础级别。
这是什么
pdfcpu 把 PDF 处理做成一个单文件 CLI:下载对应平台的二进制,chmod +x 就能跑。它既能当命令行工具,也能作为 Go 库嵌进后端服务,官方列出的能力包括校验、优化、拆分、裁剪、合并、提取图片和字体、改元数据、加解密、旋转缩放、印章水印、签名完整性检查、附件管理。
它和 QPDF 的定位有重叠,但路线不同:QPDF 更偏底层对象与结构,pdfcpu 更偏「一条命令完成一个业务动作」,而且单二进制部署对容器和边缘机器很友好。
我怎么用它
- 先跑 pdfcpu validate,确认文件结构没坏,再进后续流程;
- 用 optimize 压一遍对象流,扫描件体积能降一点,但别指望它替代图片压缩;
- 合并按文件名排序,脚本里先 sort 再传,不然顺序会乱;
- 给每页加页码或水印用 stamp,把字体和位置写成配置,批量复用;
- 打包进 Docker 时只拷二进制,镜像能做得很小,启动也快。
上手截图
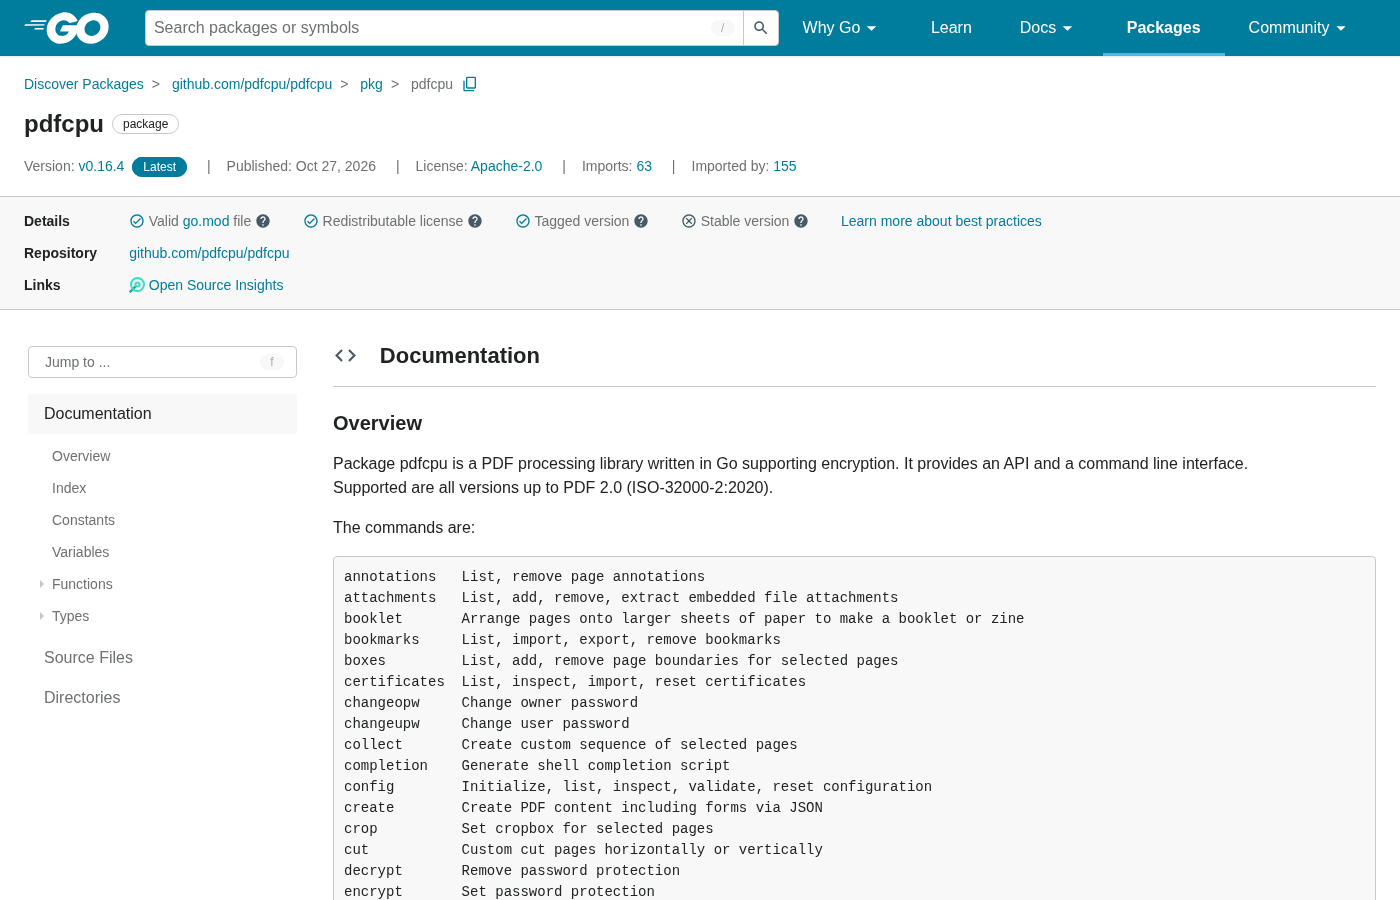
图:pdfcpu 的 Go 包文档页,v0.16.4、Apache-2.0,命令列表从 annotations 到 encrypt 一目了然
优点
- 单二进制、零运行时依赖,Windows、Linux、macOS 都能直接跑;
- 命令覆盖的业务面广,合并、拆分、印章、加密不用拼多个工具;
- Apache-2.0,Go 库还能直接嵌进自己的服务;
- 批处理和容器场景友好,镜像体积和启动时间都好控制。
缺点
- 只有命令行,没有图形界面,非技术同事用不了;
- PDF 2.0 校验只是基础支持,复杂新规范文件仍可能报错;
- 不做 OCR、不渲染页面、不抽正文,别把它当全能编辑器;
- 印章和水印要配字体,字体路径不对会直接失败。
什么时候别用它
要拖拽页面、改文字、OCR,选 PDF Arranger、PDFgear 或 Stirling。只做底层结构修复和线性化,QPDF 更专;要一个命令搞定业务动作,pdfcpu 更顺。
网友评论