详细介绍
一句话结论:QPDF 是动 PDF 结构而不是动内容的工具:Apache-2.0、GitHub 5.6k star、当前 12.4.2,支持线性化、加密解密、拆分合并、对象检查。它不渲染页面、不抽文字,所以不会把排版弄坏;代价是没有图形界面,得习惯命令行。
这是什么
QPDF 是一个命令行工具和 C++ 库,做的叫「内容保持型转换」:把 PDF 的内部对象重新组织、压缩对象流、修交叉引用表、线性化以便快速打开,但页面上的字和图不动。它还能拆分、合并、加密、解密、检查文件结构。
它明确不管两件事:不渲染 PDF,也不做文字提取。所以你没法用它把 PDF 转图片、也没法复制正文;它适合当流水线里的「结构处理层」,不适合当阅读器。
我怎么用它
- 收到打不开的 PDF,先跑 qpdf --check,看是文件损坏还是缺字体;
- 要放到网页上快速打开,用 --linearize 重新线性化,首屏不用等整份下载;
- 发敏感文件前用 --encrypt 加密码,权限位和密码分开设;
- 把一本书按页拆成单页,或者把几十个附件合成一个,用 split / merge;
- 排查结构问题时用 QDF 模式展开对象流,能看清每个对象到底存了什么。
上手截图
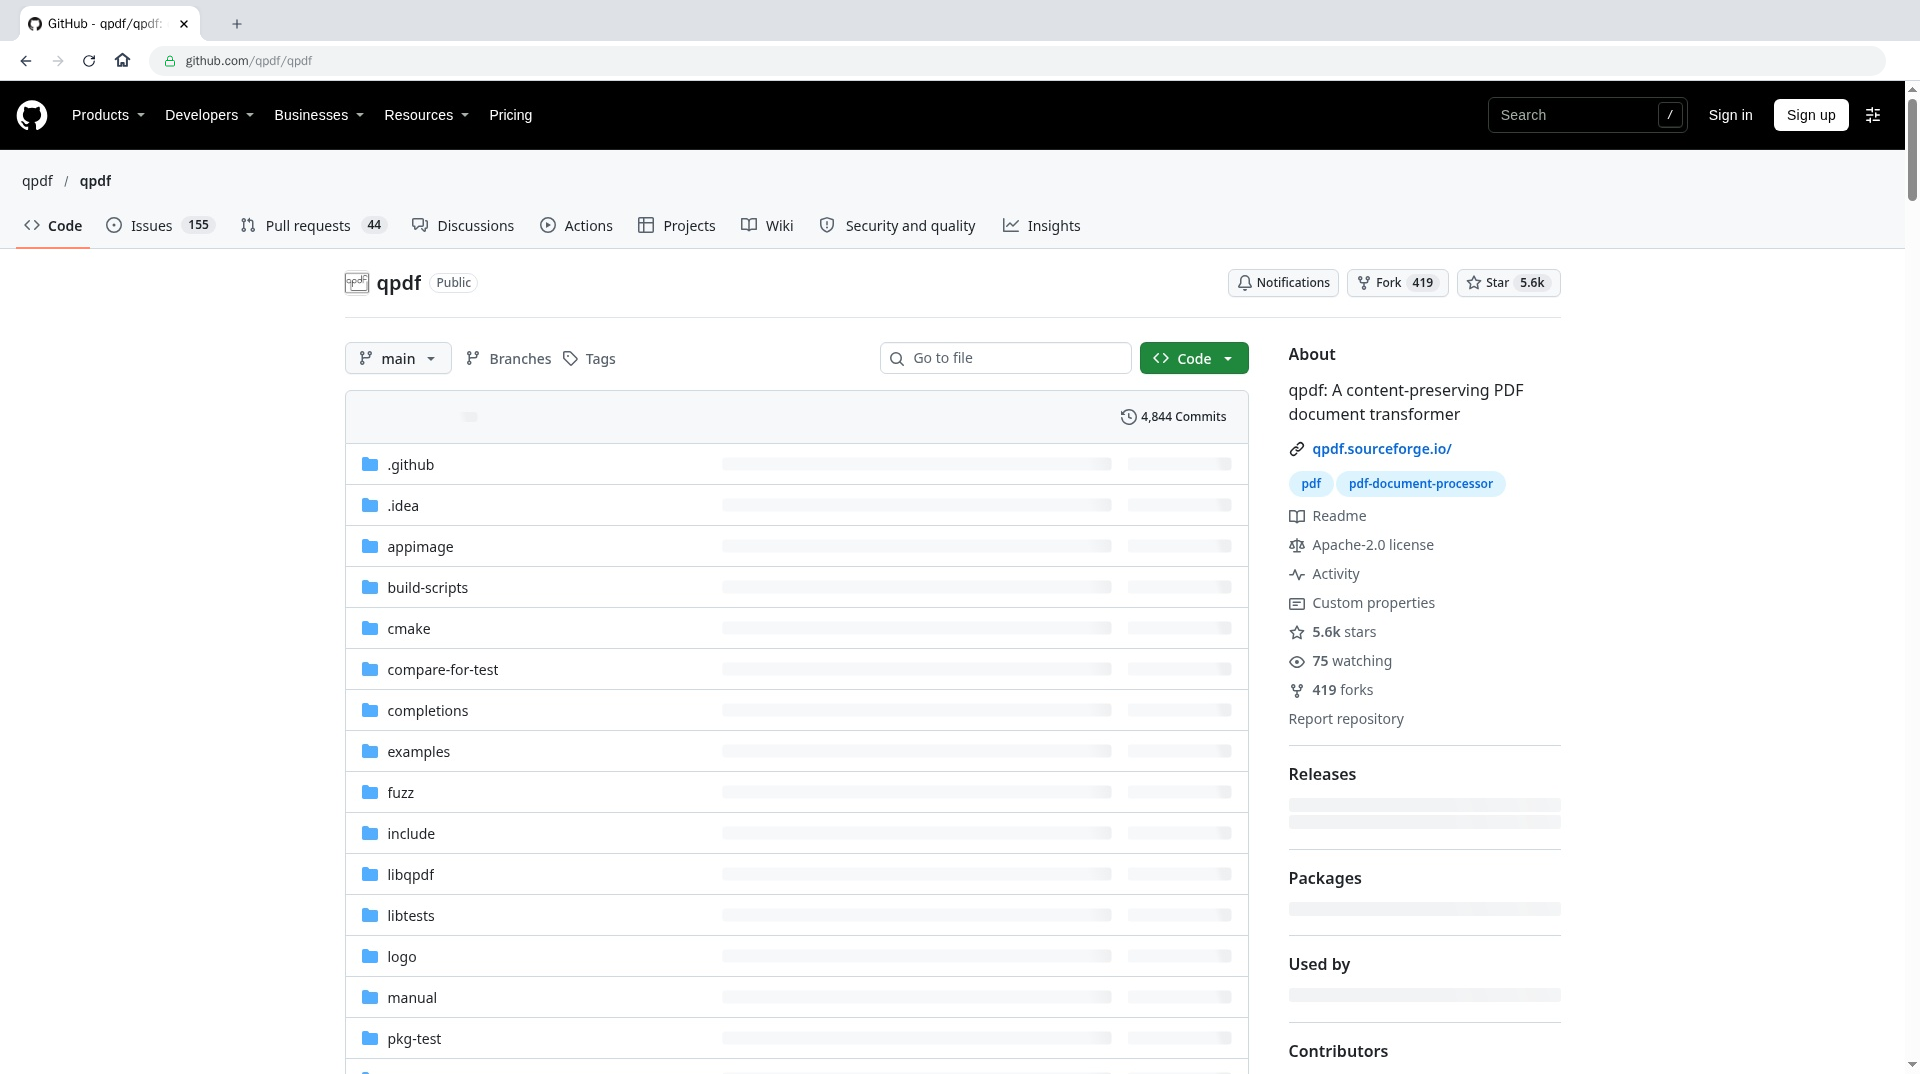
图:QPDF 的 GitHub 仓库页,5.6k star、Apache-2.0,简介写明内容保持型 PDF 转换
优点
- 无损处理结构,不会重新压图、不会改字体,原文件长什么样基本还是什么样;
- 命令行天然适合批处理和定时任务,一条 for 循环就能处理一个目录;
- Apache-2.0,商用和再分发都宽松;
- 主流 Linux 发行版和包管理器基本都有,装起来不用编译。
缺点
- 没有图形界面,参数多,第一次用要翻文档;
- 不渲染、不抽文字、不 OCR,不能替代阅读器或编辑器;
- 加密文件要先给密码,批量处理时密码管理得自己想办法;
- 报错信息偏底层,结构坏了要懂一点 PDF 对象知识才看得懂。
什么时候别用它
要可视化拖页面,用 PDF Arranger;要改正文、OCR,用 PDFgear 或 Stirling。只是想把几份 PDF 合成一份、又不想学命令,也别硬上 QPDF。
网友评论