详细介绍
一句话结论:Prometheus 加 Grafana 是自建指标看板的标准答案:前者 Apache-2.0、67.8k star,后者 AGPL-3.0、78k star,软件 0 美元;但 Prometheus 默认只留 15 天数据,长期存储要自己解决。
这是什么
Prometheus 是拉模式的时序数据库加监控系统:它按配置的间隔去抓目标暴露的 /metrics,把样本存进本地 TSDB,用 PromQL 查询和告警。Grafana 负责把这些指标画成看板。两个都是自建免费,没有按主机或按指标的授权费。
几个必须知道的默认值:Prometheus 本地保留期默认 15 天,可以用 --storage.tsdb.retention.time 或 retention.size 改;数据按 2 小时一个块落盘,再后台合并;它只依赖本地磁盘,单机不集群。告警规则算完之后的去重、分组、静默由单独的 Alertmanager 负责。默认端口 Prometheus 9090、Grafana 3000、Alertmanager 9093。
我怎么用它
我不会一上来就上整套,先跑通「一台机器 → 一张图 → 一条告警」再扩:
- 被监控机器装 node_exporter,先确认 9100 端口能抓到 CPU、内存、磁盘;
- Prometheus 配一个 job,scrape_interval 先按官方示例的 15s 跑,稳定后再调;
- Grafana 加 Prometheus 数据源,直接导入 Node Exporter 官方看板,不自己画;
- 告警写成 PromQL 规则,先进 Alertmanager 的 grouping,再决定发给谁;
- 需要留一年数据时,接远程写或对象存储,不要硬把本地 retention 拉到 365 天。
我的取舍:机器超过五台、又需要看趋势和容量规划,这套值得维护;只有三五个站要看在线率,Gatus 或 Beszel 更省人。Prometheus 的成本不在软件,在「有人愿意维护规则和看板」。
上手截图
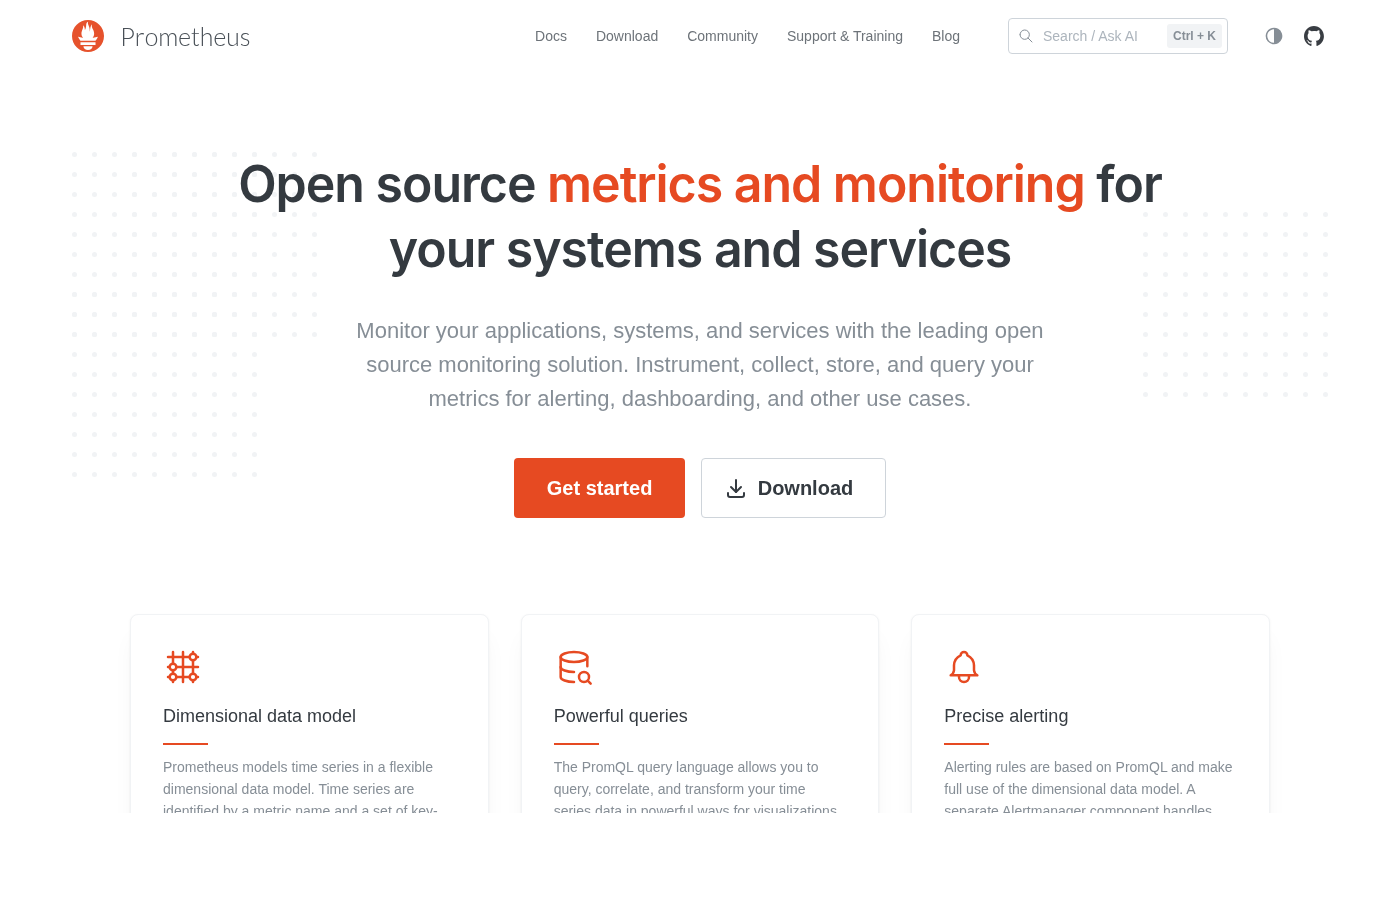
图:Prometheus 官网首屏,写明 open source metrics and monitoring,下面是维度数据模型、PromQL 与告警三块
优点
- 开源生态最完整,绝大多数中间件都有现成 exporter;
- PromQL 能做的查询和关联,比多数监控面板灵活;
- Grafana 看板和告警可视化成熟,团队协作成本低;
- 软件本身免费,没有主机数或指标数的授权限制。
缺点
- 默认只留 15 天,长期趋势要额外做远程存储;
- 单机 TSDB 不集群,机器挂了历史就断了;
- 指标基数一大,内存和磁盘涨得很快,需要提前算;
- 告警去重、静默、升级要自己配 Alertmanager,学习曲线不低。
什么时候别用它
只需要「站点挂没挂」、没有指标可采、也没人维护 PromQL 的团队,别上这套。它是给已经有业务指标、要做容量分析和趋势判断的场景用的;为了三台机器装一整套 Prometheus,维护成本会超过收益。
网友评论