从日志到告警:阈值、去重与静默窗口,先定分级再定数字
更新时间:2026-11-22 13:28:29
访问次数:6
先把告警分成三级
我把所有告警分三档,每一档对应不同的打扰方式:
- P1 业务不可用:站点 5xx、支付链路失败、核心接口超时——立刻推 IM + 电话;
- P2 明显劣化:错误率翻倍、P95 延迟翻倍、磁盘将满——推 IM,工作时间处理;
- P3 趋势与容量:证书 30 天内到期、日志额度用到 80%——进每日摘要,不单独打扰。
分级的价值在于「减少决策」:半夜被叫醒时,你不需要判断这条消息重要不重要,级别已经替你判断完了。没有分级的告警系统,最后一定会被静音。
阈值怎么定:绝对值 + 持续时长 + 同比
只用绝对值最容易误报。我的写法是三段式:指标 + 阈值 + 持续时间。比如「5xx 比例 > 1% 且持续 5 分钟」「P95 > 800ms 且持续 10 分钟」「错误量同比上一小时 > 200%」。持续时长的作用是过滤抖动——单次超时不是故障,持续超时才是。
同比维度专治「缓慢恶化」:站点从每天 100 条错误涨到 300 条,绝对值看着都不大,但它是三倍。这类问题不会触发任何单点阈值,只能靠对比发现。
去重与聚合:一个故障只发一条
同一次故障往往会同时触发十几条告警:数据库连接失败 → 接口 500 → 网关 502 → 探活失败。如果四条各自发一遍,你会在凌晨收到四倍的噪音。
- 按指纹去重:Sentry / GlitchTip 天然按 issue 聚合,同一堆栈只算一条;
- 按时间窗聚合:5 分钟内同服务的告警合并成一条,附「已发生 N 次」;
- 按依赖关系抑制:数据库告警触发时,暂时抑制上层接口告警;
- 按状态机告警:Netdata 的 WARNING/CRITICAL 只在状态跳变时通知,不会每分钟重复。
Uptime Kuma 的「重试次数」也是同一逻辑:探测间隔 60 秒、重试 2 次,意味着要连续失败约 3 分钟才判定宕机。对核心支付链路可以设 20 秒 + 重试 1 次,对普通内容页 60 秒 + 重试 2 次就够——不然一次网络抖动就能把你叫起来。
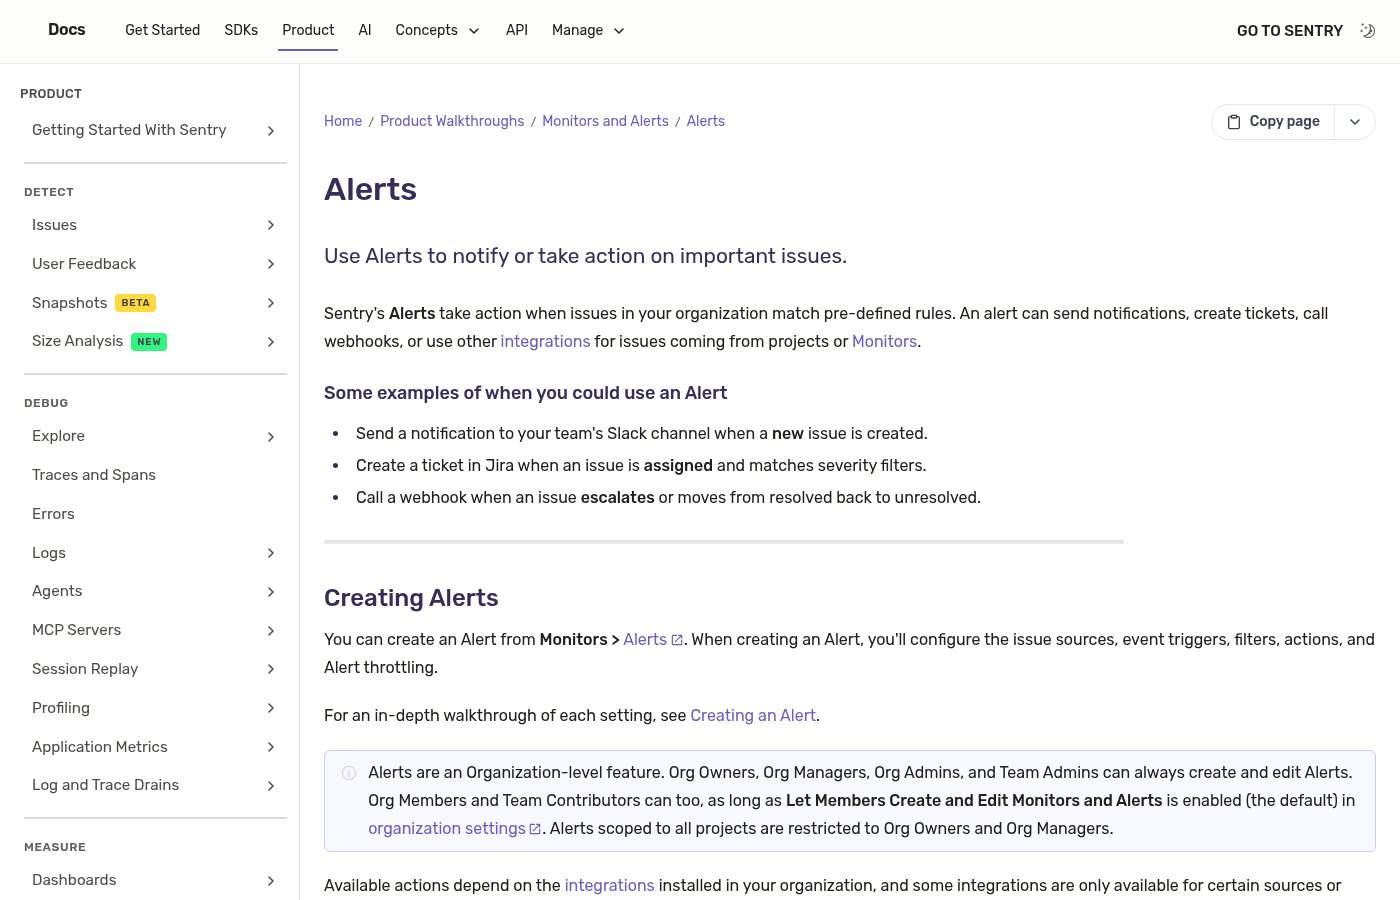
图:Sentry 告警文档,创建告警要配事件来源、触发条件、过滤器、动作和节流(throttling)
静默窗口:发布期和深夜
两条静默规则我一直在用:发布后 10 分钟内静默 P2/P3(P1 不静默),以及 23:00–07:00 只允许 P1 实时推送,其余进次日摘要。发布静默尤其重要——每次上线都会有几条预期内的错误,如果不静默,团队会养成「看到告警先忽略」的习惯,这比没有告警更危险。
最后一步:确认告警真的能到人
配完告警一定做一次演练:手动触发一条测试告警,确认 IM 收到、电话打通、值班人能说出「这条告警意味着什么、第一步该做什么」。做不到这三点的告警,等于没有。
我的原则很简单:每一条告警都必须对应一个明确动作。想不出动作的指标,就不要设告警,放进看板自己看就好。
网友评论