日志保留与采样:免费额度装不下全量,先砍噪音再谈存储
更新时间:2026-11-22 13:28:25
访问次数:5
先算清楚你到底有多少日志
一个中等流量的站点,每天原始日志量大概是这样堆出来的:访问日志 1–3GB、应用日志 200MB–1GB、容器与系统日志几百 MB。按每天 5GB 算,一个月就是 150GB——没有任何一家的免费档装得下。所以在选工具之前,第一步不是比价格,是砍量。
常用的免费额度长这样:Axiom 个人版每月 500GB 写入、25GB 存储、30 天;阿里云 SLS 每月 500MB 存储 + 500MB 索引 + 500MB 读写流量、100 万次读写;Better Stack 免费档给 3GB 日志、只留 3 天。这几个数字的差别不是「谁大方」,而是三种不同的产品假设:Axiom 假设你写入多、查得少;SLS 假设你是小规模国内业务;Better Stack 假设你只要短期排障。
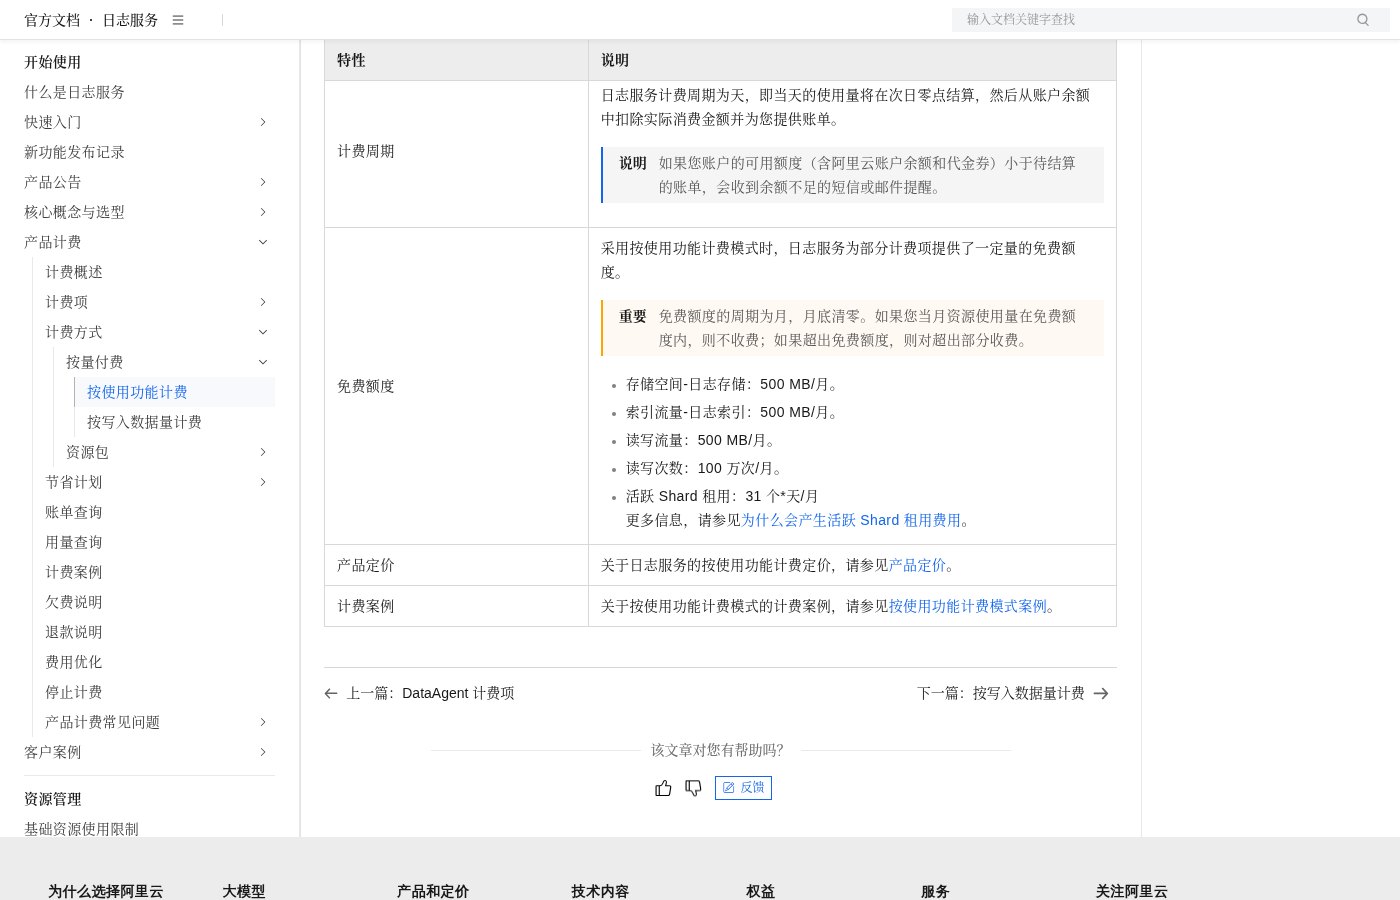
图:阿里云 SLS 计费文档里的免费额度清单,存储、索引、读写流量各 500MB/月,月底清零
500GB 写入配 25GB 存储,说明什么
Axiom 这个比例值得单独说:每月允许写入 500GB,但只给你 25GB 存储。20:1 的差距不是算错,而是它默认文本日志会被压缩到二十分之一左右——JSON 日志里大量重复的字段名、时间戳格式、相同的 service 名,压缩后确实能掉到这个量级。
这也意味着:如果你往日志里塞了 base64 图片、完整请求体、大段 HTML,压缩比会急剧下降,25GB 可能几天就满。我的规矩是日志里只放「能定位问题的字段」:时间、级别、service、trace_id、错误码、耗时,请求体只留前 200 字符并且脱敏。
采样怎么抽才不丢关键错误
按级别分流是最稳的做法,比随机采样可靠得多:
- ERROR / FATAL:100% 保留,永不采样——这是你唯一不能赌的部分;
- WARN:100% 保留,但设每日上限,超过就只留计数;
- INFO:按 trace_id 取模采样 10%,保证同一次请求的日志要么全在、要么全不在;
- DEBUG:生产环境默认关闭,需要时按机器临时打开 30 分钟;
- 健康检查、探活、静态资源访问:直接丢弃,这类日志通常占总量的一半以上。
为什么用 trace_id 取模而不是随机丢?因为排障靠的是上下文:一次请求的「进入→调用下游→返回→报错」四行日志,如果随机丢两条,剩下的两条反而更难读。按 trace_id 取模能保证同一链路的日志完整性。
保留策略:分层,而不是一刀切
| 层级 | 时长 | 保留内容 | 存放位置 |
|---|---|---|---|
| 热层(可检索) | 7 天 | 全量 ERROR/WARN + 10% INFO | Axiom / SLS 免费额度 |
| 温层(可查不快) | 30 天 | ERROR 全量 + 1% INFO | 对象存储 + 按需导入 |
| 冷层(合规归档) | 180 天+ | 仅审计相关事件 | 压缩包 + 校验和 |
我的实际配置是:热层 7 天,因为 90% 的排障发生在故障后 24 小时内;温层 30 天,只留错误;冷层按业务需要,日志不进冷层,只把「谁在什么时候改了什么」这类审计事件单独存。这样一算,免费额度不但够,还能留出突发流量的余量。
最后提醒一句:日志里的手机号、身份证、token、完整 URL 参数,都属于个人信息。采样和脱敏要在「写入前」做,不要指望存储端帮你删——删的时候它已经存过一遍了。
网友评论