错误追踪怎么选:错误量、保留期、采样率三个数决定账单
更新时间:2026-11-22 13:28:22
访问次数:12
先把「错误量」算成钱
很多人选工具时盯着「功能多不多」,真正决定账单的是每月事件数。先算一遍:日 PV × 错误率 × 30。日 PV 10 万的站,就算 1% 的请求出错,一个月也是 3 万条错误;日 PV 1 万、错误率 0.5%,一个月只有 1,500 条,免费档绰绰有余。
| 方案 | 价格 | 成员 | 每月额度 | 保留 |
|---|---|---|---|---|
| Sentry Developer | 免费 | 1 个 | 5,000 | 30 天 |
| Sentry Team | 26 美元/月 | 不限 | 50,000 | 90 天 |
| GlitchTip Hobby | 免费 | 不限 | 1,000 | 30 天 |
| GlitchTip Small | 15 美元/月 | 不限 | 100,000 | 90 天 |
| Axiom Personal | 免费 | — | 按写入量 500GB/月 | 30 天 |
| Netdata Community | 免费 | — | 5 台机器 | 本地留存 |
把单价折成「每千条」更直观:Sentry Team 26 美元买 5 万条,是 0.52 美元/千条;GlitchTip Small 15 美元买 10 万条,是 0.15 美元/千条。差了 3.5 倍——同样的错误量,一家收 520 美元时另一家收 150 美元。
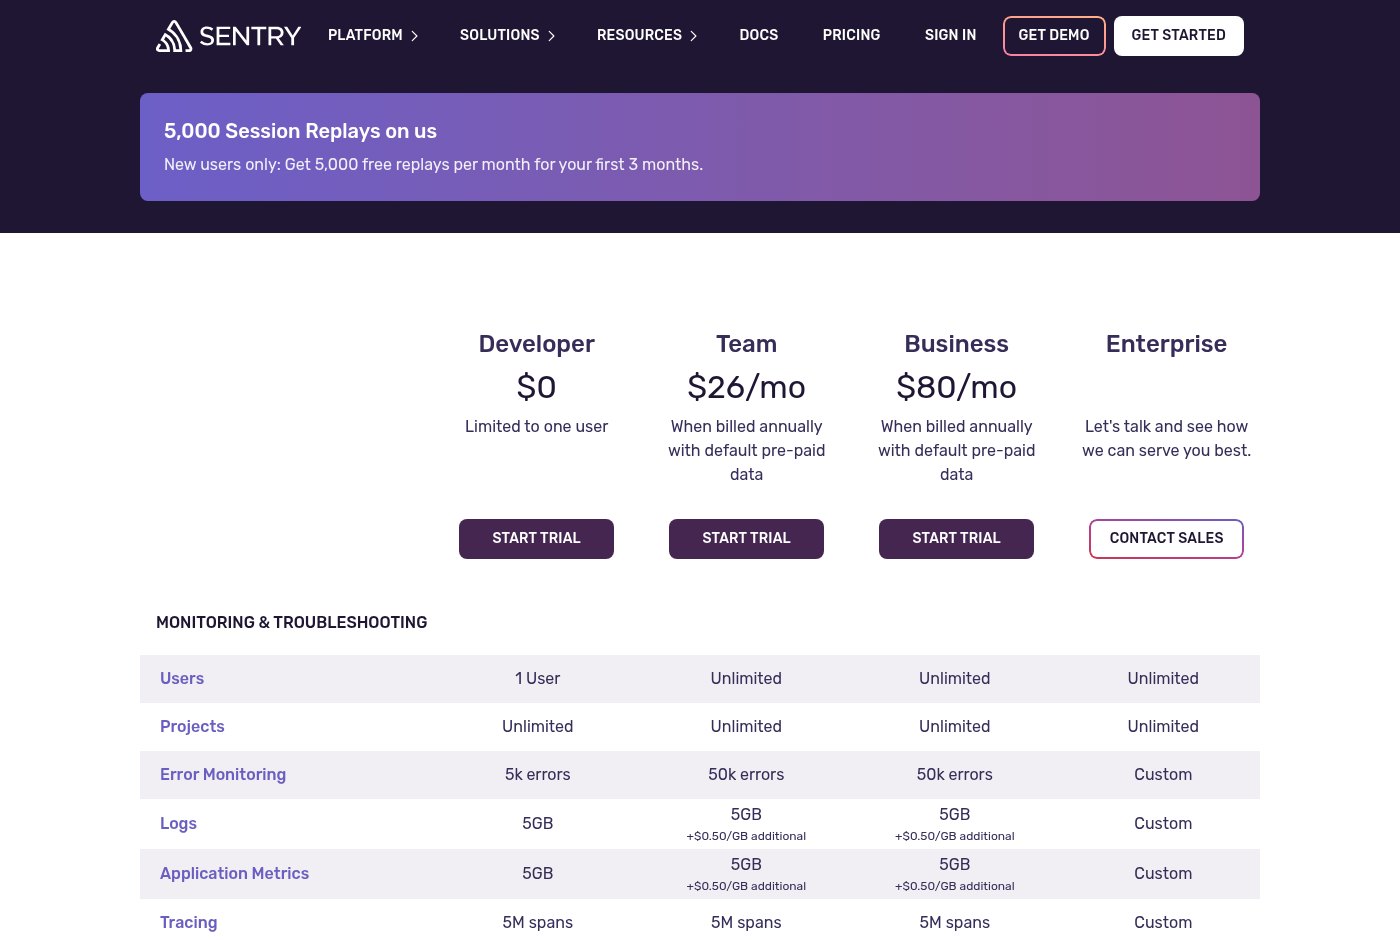
图:Sentry 官方定价对比表,5k errors 与 50k errors 的分界线就在 Team 档
保留期是最容易被忽略的一栏
免费档普遍给 30 天回看,付费档给 90 天。30 天够不够?取决于你要拿它做什么:定位当天的线上问题是够的;要做「这个 bug 是不是上个月改出来的」这种回溯,30 天就会断片。我的做法是:日常排障靠 30 天窗口,版本级复盘靠 release 标签和提交记录,不指望工具替我留一年。
如果业务有合规要求(金融、医疗、等保),30 天直接不合格,这时别在免费档上纠结功能,先看对方能不能签数据处理协议、数据存在哪个区域。Sentry 和 GlitchTip 都提供欧盟区域托管选项,GlitchTip 还能整站搬到自己的服务器上——这一条对合规场景比省几十美元重要得多。
采样率:省钱的开关,也是漏报的开关
错误采样(sampleRate)和链路采样(tracesSampleRate)要分开设。我的默认配置是:错误 100% 上报,链路 10%,慢查询单独开。原因是错误的样本量本来就小,一旦采样,低频但致命的错误(比如只有特定机型才触发的崩溃)可能永远不出现;而链路数据量大、重复度高,10% 已经足够看出趋势。
还有一个隐藏的成本项:突发流量。一次发版 bug 可能让同一个错误在几分钟内循环上报几万次,直接把月度额度打满。Sentry 和 GlitchTip 都有 inbound filter / 速率限制,务必打开「同一 issue 每小时最多 N 条」,别让一个 bug 吃掉整个月的预算。
我的选型结论
- 单人、错误量 5,000/月以内:Sentry 免费档,功能最全,别折腾;
- 单人、量在 1,000–10 万之间、想省钱:GlitchTip 托管 Small,单价最低;
- 有运维、要求数据不出自己机房:GlitchTip 自建,软件免费,成本是机器和人力;
- 主要看服务器指标而不是错误堆栈:Netdata 免费 5 节点,先把它装上;
- 日志量大、要长期查:Axiom 免费档做 30 天窗口,长期归档另存对象存储。
别一次上两套系统。错误追踪的价值在于「所有异常都往一个地方汇」,拆成两套之后,你会花更多时间判断「这个报错到底在哪个后台」。
网友评论