监控频率怎么选:5 分钟、1 分钟、10 秒分别适合什么站
更新时间:2026-11-22 09:26:02
访问次数:6
详细介绍
一句话结论:对绝大多数站,5 分钟一次 + 连续两次失败才告警,已经比 90% 的同行快;1 分钟一次是给核心交易路径的;10 秒级只用来验证「抖动」而不是日常监控。频率每提高一档,请求量翻 5 到 6 倍,误报也跟着涨。
先把请求量算出来
频率的代价是线性的,很多人只算「一次请求很便宜」,忘了乘上监控数量和天数。按单监控算:
| 频率 | 每天请求数 | 每月请求数 | 适用场景 |
|---|---|---|---|
| 5 分钟 | 288 | 8,640 | 免费档的默认档位,普通内容页够用 |
| 1 分钟 | 1,440 | 43,200 | 支付、登录、核心 API |
| 30 秒 | 2,880 | 86,400 | 大促期间的临时加密 |
| 10 秒 | 8,640 | 259,200 | 只在排查抖动时开几小时 |
乘上监控数量就更直观:50 个监控跑 1 分钟,一天 72,000 次请求、一个月 216 万次。免费档里没几家的额度扛得住这个量,这也是为什么大部分免费套餐默认 5 分钟。
告警噪音几乎全来自「一次失败就报」
把频率调密,最先坏掉的是注意力而不是服务器。我的做法是两层过滤:
- 第一层是连续失败次数:连续 2 次失败才告警,单次失败只记日志;
- 第二层是宽限期(Grace Time):该来没来先算 Late,超过宽限才算 Down,Healthchecks.io 就是这么设计的;
- 宽限期按任务真实耗时定:备份任务跑 40 分钟,宽限就给 15 分钟,别给 2 分钟;
- 告警分级:短信只给「全站不可用」,Slack 给「单接口异常」,邮件给「慢但没挂」。
官方文档里那个例子很好用:cron 是 10 * * * *、宽限 5 分钟,12:30 成功 ping 过,13:10 判 Late、13:15 判 Down。也就是说从「该跑没跑」到「真的叫醒你」,中间留了 5 分钟给人自己发现和自我恢复的空间。
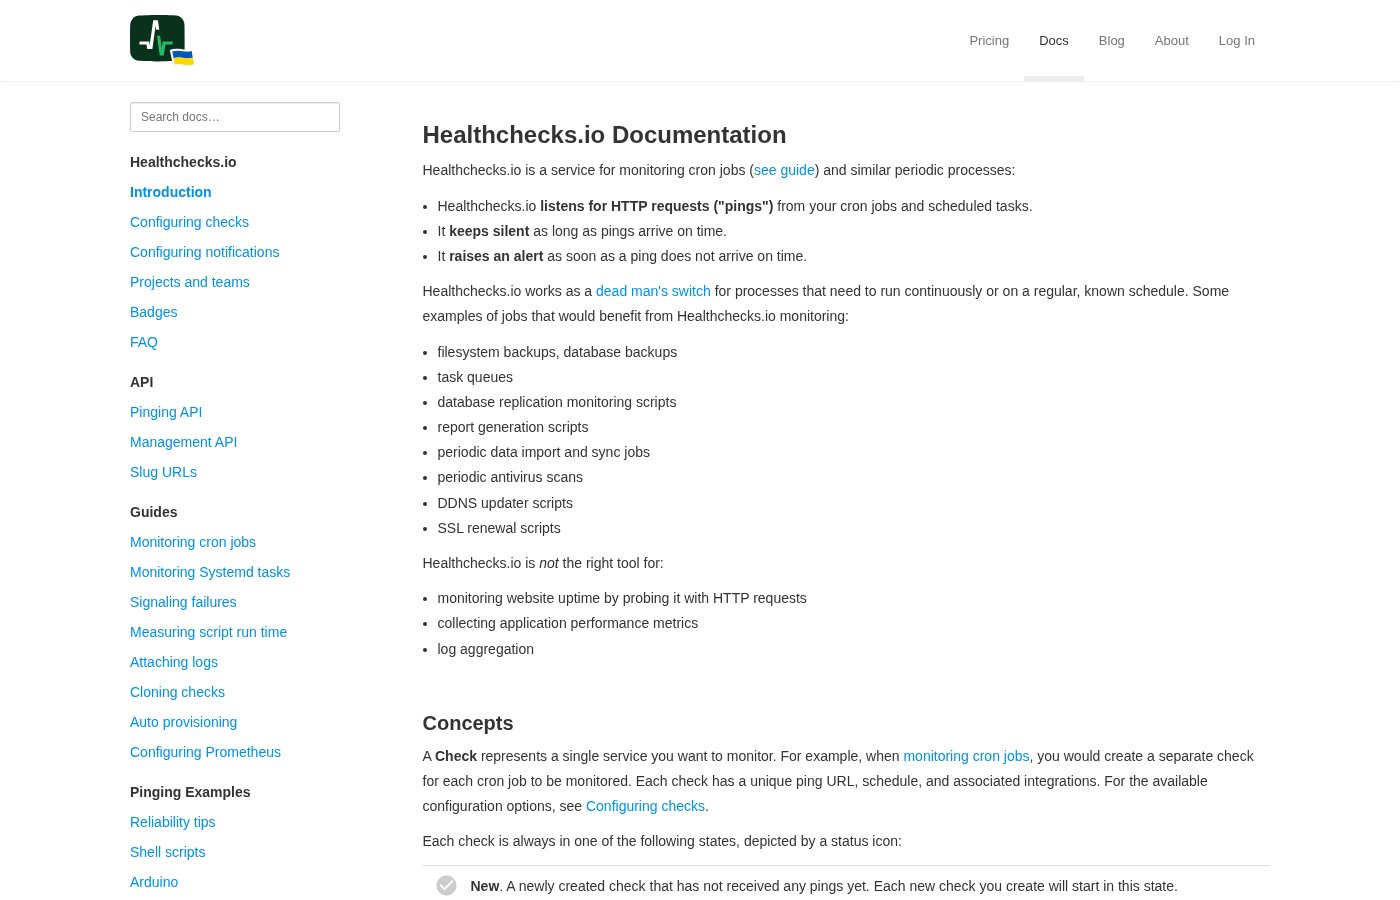
图:Healthchecks.io 文档里对 Late 与 Down 的定义,宽限期就是两级状态之间的那段缓冲
不同页面用不同频率
| 对象 | 建议频率 | 理由 |
|---|---|---|
| 首页 | 1–5 分钟 | 访问量最大,挂了等于全站挂 |
| 支付/下单接口 | 1 分钟 | 直接损失钱,值得占额度 |
| 登录/注册 | 1–5 分钟 | 挂了用户会立刻发现 |
| 普通内容页 | 5–10 分钟 | 晚 10 分钟知道不影响收入 |
| 后台/内部系统 | 10–30 分钟 | 用户少,用告警而不是拨测 |
还有一个容易被忽略的点:拨测节点在哪。境外节点每 5 分钟问一次,只能说明「境外能访问」,国内用户的体感要靠国内节点测——腾讯云拨测的试用档最高就是 5 分钟、单任务最多 6 个节点,这个配置用来做「地区 × 运营商」的对照刚好够,但不够做秒级抖动分析。
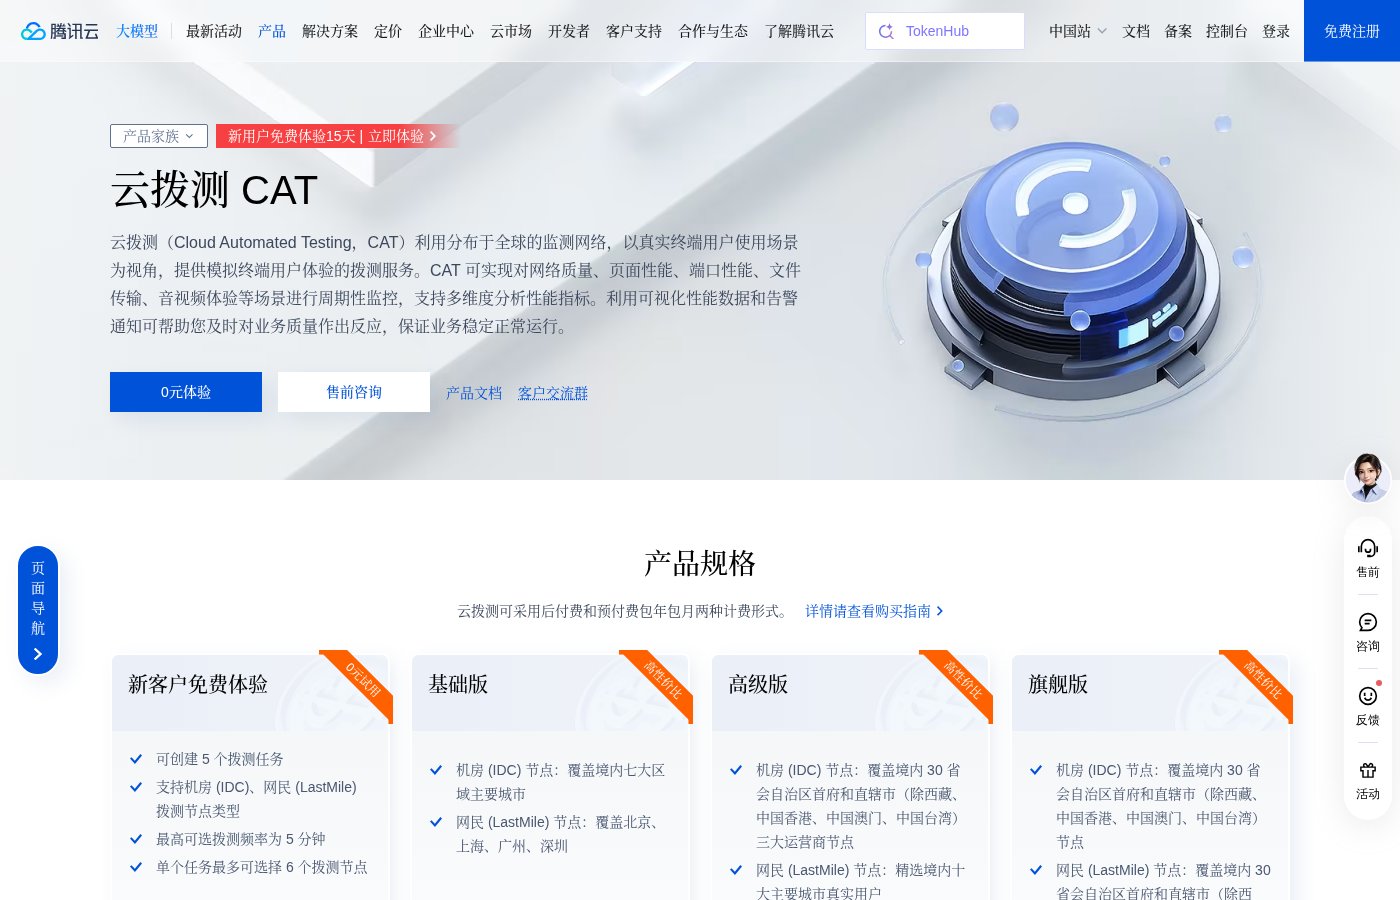
图:云拨测试用档的规格,最高频率 5 分钟、单任务 6 个节点,正好是「对照」而不是「秒级」的量级
我的定档方案
个人站和中小站:全部 5 分钟,连续 2 次失败告警,只留一个短信通道给首页。日订单过百的电商:支付与下单 1 分钟,其余 5 分钟。大促当天临时把支付拉到 30 秒,活动结束立刻改回去——临时加密的监控如果忘了关,一个月后你会收到一张额度超限的账单。
频率这件事的正确答案不是某个数字,而是「你能不能在 5 分钟内判断真假」。判断不了的告警,再密也只是噪音。
网友评论